Dans la course vers la performance numérique et l’agilité décisionnelle, les directions générales sont confrontées à un carrefour d’infrastructure déterminant. L’architecture des données d’une organisation n’est jamais neutre : elle constitue soit un actif stratégique qui accélère la prise de décision, soit un passif opérationnel qui freine la croissance.
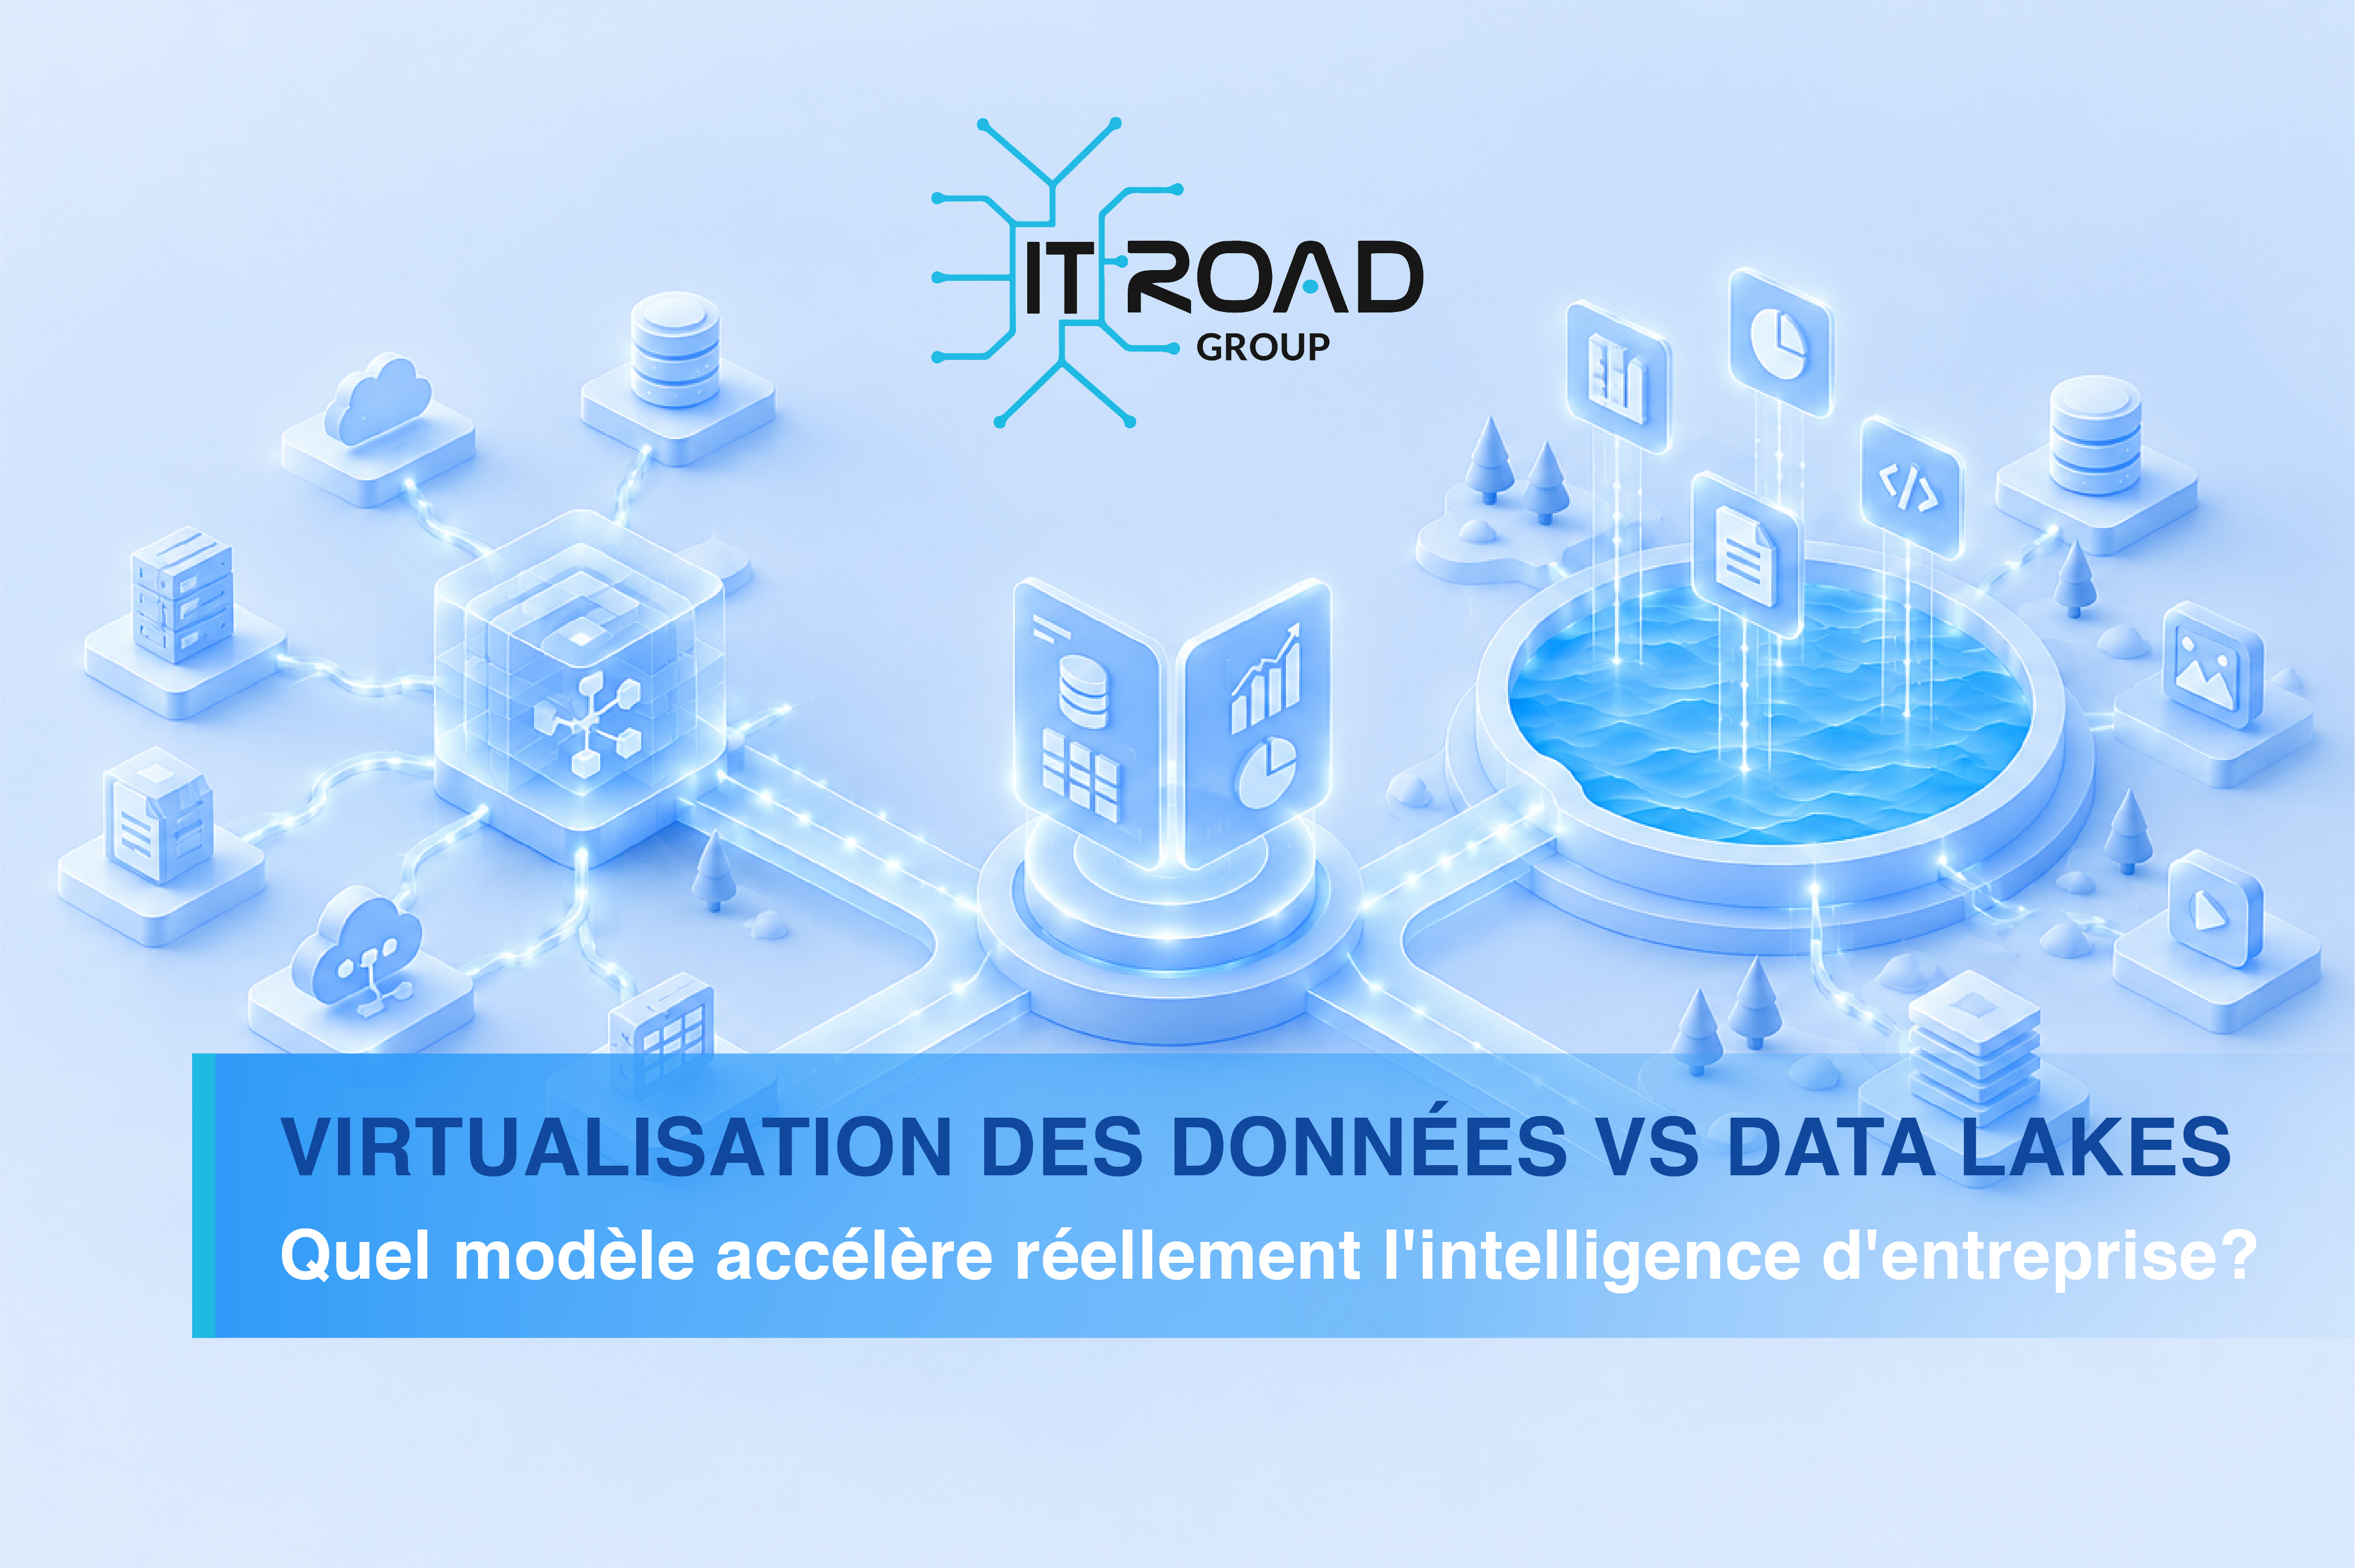
Pendant de nombreuses années, le réflexe des directions informatiques a consisté à déployer un Data Lake centralisé. L’objectif était de stocker l’intégralité des données brutes au sein d’un réservoir physique unique afin de décloisonner l’information. Néanmoins, les impératifs actuels de réactivité exigent des analyses immédiates et exploitables, et non des chantiers de stockage pluriannuels. C’est pourquoi les DSI et directeurs de l’architecture se tournent résolument vers la virtualisation des données. Pour identifier l’approche qui accélère véritablement l’intelligence d’entreprise, il convient d’analyser la confrontation entre centralisation physique et abstraction logique en temps réel.
Le Data Lake : L’Approche par Consolidation Physique
Un Data Lake est un système de stockage physique centralisé qui accueille des volumes massifs de données brutes, qu’elles soient hautement structurées, semi-structurées ou non structurées, dans leur format d’origine. En découplant le calcul du stockage, il autorise l’ingestion d’informations sans imposer de schéma rigide au moment de l’écriture.
Cette architecture répond traditionnellement à des cas d’usage industriels bien identifiés :
- Stockage de Masse à Coût Maîtrisé : Le Data Lake absorbe économiquement des flux continus de journaux serveurs, de métriques IoT et d’archives textuelles complexes.
- Exploration et Recherche en Data Science : Grâce au mécanisme du schéma à la lecture (schema-on-read), les ingénieurs machine learning et data scientists peuvent exploiter la donnée brute pour entraîner des modèles prédictifs complexes.
- Constitution d’un Référentiel Historique : Il offre une base d’archivage durable pour les audits réglementaires rétroactifs et les analyses longitudinales sur plusieurs exercices.
Cependant, faire reposer l’ensemble de l’intelligence d’entreprise sur un Data Lake engendre des frictions opérationnelles chroniques :
- La Dépendance aux Pipelines d’Ingestion : Alimenter physiquement un Data Lake exige le développement et le maintien continu de flux ETL complexes. Ces chaînes de traitement demandent des mois d’ajustements et s’avèrent très vulnérables aux modifications des schémas sources.
- Délais de Mise à Disposition de l’Information : Les données brutes devant subir des étapes successives de nettoyage, de normalisation et d’indexation avant d’être interrogeables, les décideurs subissent des temps de latence préjudiciables pour leurs tableaux de bord quotidiens.
- Le Péril du « Marais de Données » (Data Swamp) : En l’absence d’une indexation méticuleuse et d’une gouvernance continue, le lac de données se transforme inévitablement en un espace désorganisé dans lequel les équipes métiers ne peuvent plus garantir la fiabilité des indicateurs.
La Virtualisation des Données : L’Approche par Abstraction Logique
À l’opposé de cette logique de déplacement, la virtualisation des données traite l’intégration sous l’angle de la connectivité logique en temps réel. Elle met en place une passerelle d’abstraction performante directement au-dessus des systèmes opérationnels existants.
En interrogeant l’information là où elle réside, l’architecture logique transforme l’accès à la connaissance d’entreprise :
- Zéro Déplacement Physique des Données : L’information demeure au sein de ses bases opérationnelles sécurisées, éliminant ainsi les coûts de duplication du stockage, la latence des synchronisations et les frais de bande passante.
- Fédération de Requêtes en Temps Réel : Le moteur logique traduit et distribue les requêtes complexes vers les différentes sources informatiques en simultané, synthétisant les résultats instantanément pour l’utilisateur final.
- Gouvernance et Sécurité Consolidées : Une passerelle logique unique centralise le contrôle des accès, l’application des règles de masquage dynamique et les pistes d’audit pour l’ensemble des environnements on-premise et cloud.
Analyse Comparative : Déplacement Physique vs. Abstraction Logique
La mise en parallèle de ces deux modèles révèle des divergences structurelles sur chaque grand critère d’évaluation :
- Circulation et Duplication des Données : Le Data Lake impose de copier physiquement de volumineux volumes d’information d’un environnement à un autre. La virtualisation des données ne déplace aucun octet et interroge directement les bases maîtresses de manière optimisée.
- Cycle de Mise en Production : L’ingénierie des flux ETL pour un Data Lake s’étale fréquemment sur plusieurs trimestres. Avec la virtualisation des données, la publication de nouvelles vues logiques et de modèles métiers s’effectue en quelques jours.
- Fraîcheur des Indicateurs Stratégiques : Les données d’un lac représentent un état figé issu du dernier traitement par lots (batch). La virtualisation capture la réalité exacte du système transactionnel à la seconde où la requête est exécutée.
- Complexité de la Gouvernance : Un Data Lake exige de recréer et de surveiller une matrice complète de droits d’accès au sein du stockage cible. La virtualisation unifie l’application des politiques de conformité à l’échelle de l’entreprise au sein d’un point de contrôle logique centralisé.
- Finalité Principale : Le Data Lake constitue un environnement dédié à l’expérimentation statistique, au machine learning massif et à la rétention d’archives. La virtualisation des données représente l’accélérateur direct de la veille opérationnelle, des tableaux de bord du comité de direction et du pilotage métier décloisonné.
Le Verdict Stratégique : Quel Modèle Accélère Réellement la Décision ?
Chacune de ces deux technologies possède sa pertinence technique, mais elles répondent à des finalités métiers différentes.
Lorsque le projet consiste à stocker des téraoctets de données non structurées pour entraîner des modèles de deep learning sur plusieurs années d’historique, le Data Lake conserve toute son utilité.
En revanche, lorsque la priorité de la direction générale est d’obtenir une vision transverse et instantanée des performances financières, logistiques et commerciales, la virtualisation des données s’affirme comme le véritable accélérateur de l’intelligence d’entreprise. Tenter d’unifier les indicateurs métiers en recopiant manuellement chaque base vers un réservoir unique introduit des délais inacceptables et une complexité superflue. La virtualisation comble immédiatement le fossé entre les systèmes existants et fournit une vérité métier fiable sans perturber les opérations en cours.
L’Accompagnement d’IT Road Group et la Technologie Denodo
Chez IT Road Group, nous avons la certitude qu’une transformation numérique pérenne repose avant tout sur un schéma directeur rigoureux. Aucun composant technologique ne doit être implanté sans une vision d’ensemble cohérente.
À travers notre pôle Conseil Stratégique et Gestion des Données, nos spécialistes accompagnent les dirigeants pour simplifier leurs cartographies applicatives et neutraliser les silos organisationnels. Pour conjuguer rapidité d’accès et sécurité des systèmes, nous déployons des architectures logiques de pointe en collaboration étroite avec notre partenaire stratégique Denodo, leader mondial de la virtualisation des données.
Aux côtés de Denodo, nous valorisons l’intégralité de vos actifs numériques :
- Nous supprimons les chantiers de migration physique pluriannuels, coûteux et risqués pour la continuité de vos activités.
- Nous érigeons une passerelle d’accès logique cohérente unifiant vos infrastructures sur site et vos écosystèmes multi-cloud.
- Nous assurons le respect scrupuleux des normes de gouvernance internationales ainsi que des directives de la loi marocaine 09-08 encadrée par la CNDP.
Nous transformons la complexité de votre système d’information en un puissant moteur de performance collective.
FAQ
En quoi la virtualisation des données se distingue-t-elle d’un Data Lake ?
Le Data Lake extrait, recopie et concentre physiquement les données brutes au sein d’un espace de stockage centralisé. La virtualisation des données interroge directement les bases de données sources sur leur site d’hébergement, créant une couche d’accès logique en temps réel sans jamais déplacer physiquement l’information.
La virtualisation des données peut-elle compléter un Data Lake déjà en place ?
Tout à fait. La virtualisation des données peut intégrer le Data Lake existant comme une source parmi d’autres. Elle permet ainsi d’interroger conjointement le lac, les progiciels ERP, les outils CRM et les bases relationnelles au travers d’une passerelle fédérée unique.
Pourquoi la virtualisation des données accélère-t-elle le time-to-value par rapport aux flux ETL ?
Les architectures ETL classiques imposent un travail long et fastidieux de modélisation, de transport physique et de transformation par lots. La virtualisation des données permet de publier des modèles d’analyse et des vues métiers en quelques jours, en se connectant directement aux schémas sources.
Comment la plateforme Denodo intervient-elle dans cette architecture ?
Denodo offre un socle logiciel moderne capable d’exécuter des optimisations dynamiques de requêtes, de gérer des caches distribués intelligents et de centraliser un catalogue de données d’entreprise. IT Road Group s’appuie sur la solution Denodo pour fédérer les systèmes hétérogènes de ses clients sans complexité de transfert.
En quoi la loi 09-08 de la CNDP au Maroc impacte-t-elle ce choix d’architecture ?
La loi 09-08 fixe des règles strictes sur la conservation, le traitement et le transfert transfrontalier des données à caractère personnel. En évitant la multiplication de copies physiques et le transfert redondant de données sensibles vers des stockages distants, la virtualisation des données limite considérablement les risques de non-conformité réglementaire.